Pourquoi ChatGPT ne donne jamais deux fois la même réponse (et comment mesurer quand même)
Posez deux fois la même question à ChatGPT : vous obtiendrez deux réponses différentes, et souvent deux listes de marques différentes. Ce n’est pas un défaut, c’est le fonctionnement même du modèle. Voici les cinq causes, ce qu’elles changent pour votre visibilité, et la seule façon fiable de mesurer une présence qui varie.
ChatGPT ne donne jamais deux fois la même réponse parce qu’il génère son texte en tirant chaque mot parmi plusieurs possibles, et parce qu’en mode recherche il interroge le web différemment à chaque fois. Pour une marque, la conséquence est directe : une capture où vous êtes cité, ou absent, ne prouve rien. L’étude de SparkToro montre que ChatGPT et l’IA de Google renvoient la même liste de marques moins d’une fois sur cent. Ce qui reste stable, c’est la fréquence à laquelle une marque apparaît — et c’est elle qu’il faut mesurer.
Les cinq causes de la variation
1. Le tirage des mots
Un modèle de langage ne choisit pas « le » mot suivant : il calcule une probabilité pour chaque mot possible, puis en tire un. Ce tirage est volontairement aléatoire pour produire un texte naturel. Une marque citée en deuxième position dans une réponse peut ne pas apparaître dans la suivante, simplement parce que la phrase a pris un autre chemin.
2. La recherche web, refaite à chaque fois
Quand ChatGPT cherche sur le web, il reformule la question en une ou plusieurs requêtes. L’étude de Profound sur 10 000 prompts (avril 2026) montre que 91 % de ces requêtes sont uniques : ChatGPT ne lance presque jamais deux fois la même recherche pour la même question. Des requêtes différentes ramènent des pages différentes, donc des marques différentes. Nous détaillons ce mécanisme dans un article consacré à la recherche web de ChatGPT.
3. Le contexte de l’utilisateur
Mémoire des conversations, instructions personnalisées, historique de la discussion en cours et localisation approximative modifient la réponse. Deux personnes qui posent la même question n’obtiennent pas la même chose — c’est voulu.
4. Le modèle utilisé
Selon l’offre et la charge, ChatGPT n’utilise pas toujours le même modèle, et les versions changent plusieurs fois par an. Un modèle de raisonnement lance davantage de recherches qu’un modèle rapide, et cite d’autres sources.
5. La formulation exacte
« Meilleur couvreur à Lyon », « couvreur Lyon pas cher » et « qui appeler pour une fuite de toiture à Lyon » sont trois questions différentes pour le modèle. Une virgule ou un mot de plus suffit à changer la réponse.
Ce que l’étude de SparkToro a mesuré
Fin 2025, Rand Fishkin (SparkToro) et Patrick O’Donnell ont fait poser 12 questions de recommandation à ChatGPT, Claude et l’IA de Google par des centaines de volontaires, pour près de 3 000 exécutions. Résultat : la même liste de marques revient moins d’une fois sur cent, et la même liste dans le même ordre moins d’une fois sur mille.
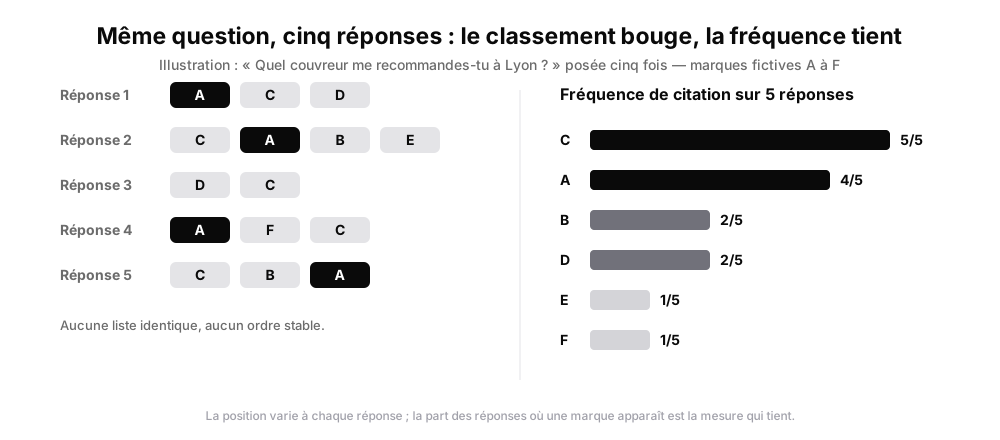
Mais l’étude relève aussi ce qui tient : la fréquence à laquelle une marque apparaît sur de nombreuses réponses est bien plus stable que sa position. Dans les catégories étroites, les marques dominantes apparaissent dans la plupart des réponses ; dans les catégories larges, les résultats sont plus dispersés.
Oubliez la « position dans ChatGPT » au sens du SEO : elle ne se reproduit pas. La métrique utile est le taux de citation — la part des réponses où vous apparaissez — mesuré sur un échantillon suffisant, et la part de voix face à vos concurrents sur les mêmes questions.
Combien de réponses faut-il pour mesurer ?
Un taux de citation est une proportion : sa précision dépend du nombre de réponses observées. Voici la marge d’erreur (intervalle de confiance à 95 %) d’un taux mesuré à 30 % :
| Réponses observées | Marge d’erreur | Ce que vous pouvez conclure |
|---|---|---|
| 1 | ±90 points | Rien : c’est une anecdote |
| 5 | ±40 points | Présence ou absence très marquée seulement |
| 10 | ±28 points | Un ordre de grandeur |
| 30 | ±16 points | Comparer avec un concurrent nettement devant ou derrière |
| 100 | ±9 points | Suivre une évolution d’un mois sur l’autre |
D’où trois règles pratiques. Additionnez les questions : 20 questions posées 5 fois donnent 100 réponses sur un même sujet. Répétez là où c’est incertain : une question où vous êtes cité une fois sur deux mérite plus de répétitions qu’une où vous êtes toujours absent. Affichez la marge : un taux sans marge d’erreur fait croire à une précision qui n’existe pas.
Combien de fois chaque question est-elle posée, et quelle est la marge d’erreur du chiffre affiché ? Si la réponse est « une fois par jour » et « pas de marge », l’évolution que vous voyez d’une semaine sur l’autre est en grande partie du bruit. Nous nous appliquons la même règle : notre méthode le précise question par question.
Ce que vous pouvez faire pour être cité plus souvent
La variabilité n’est pas qu’un problème de mesure : c’est aussi une opportunité. Une marque citée 3 fois sur 10 peut passer à 6 sur 10, parce que le modèle a plus souvent de bonnes raisons de la retenir. Les leviers qui augmentent cette fréquence :
- Être présent dans plusieurs sources indépendantes : comparatifs, annuaires de référence, presse. Plus les pages qui vous mentionnent sont nombreuses, plus l’une d’elles a de chances d’être ramenée par la recherche.
- Couvrir les variantes de la question : prix, avis, comparaison, cas d’usage. Chaque formulation ramène d’autres pages.
- Rendre vos pages faciles à citer : réponse directe, faits chiffrés, sources liées — voir Comment être cité par ChatGPT.
Ce qu’il faut retenir
- ChatGPT varie par construction : tirage des mots, recherches web uniques, contexte, modèle, formulation.
- Une capture d’écran n’est pas une mesure ; la même liste de marques revient moins d’une fois sur cent.
- La fréquence de citation est stable sur un échantillon : c’est la métrique à suivre.
- Il faut au moins une trentaine de réponses par sujet pour comparer, une centaine pour suivre une évolution.
- Un chiffre sans marge d’erreur ne permet pas de savoir si une variation est réelle.
Pourquoi ChatGPT donne-t-il des réponses différentes à la même question ?
Parce que le modèle tire chaque mot parmi plusieurs possibles, de façon volontairement aléatoire, et parce qu’en mode recherche il reformule la question en requêtes web presque toujours différentes. Le contexte de l’utilisateur (mémoire, conversation, localisation), le modèle utilisé et la formulation exacte modifient aussi la réponse.
ChatGPT recommande-t-il toujours les mêmes marques ?
Non. L’étude de SparkToro (janvier 2026, près de 3 000 exécutions) montre que ChatGPT et l’IA de Google renvoient la même liste de marques moins d’une fois sur cent. En revanche, la fréquence à laquelle une marque apparaît sur de nombreuses réponses est bien plus stable.
Comment mesurer sa visibilité dans ChatGPT si les réponses changent ?
En posant un ensemble de questions réelles plusieurs fois chacune et en calculant la part des réponses où la marque apparaît (taux de citation), avec sa marge d’erreur. Sur 10 réponses, un taux de 30 % a une marge d’environ ±28 points ; sur 100 réponses, d’environ ±9 points.
La position d’une marque dans ChatGPT a-t-elle un sens ?
Peu. L’ordre des marques change presque à chaque réponse : la même liste dans le même ordre revient moins d’une fois sur mille selon SparkToro. La position moyenne sur un grand nombre de réponses peut servir d’indicateur secondaire ; le taux de citation reste la métrique principale.
Sources
À propos de l’auteur
Kelvin Rivera
Consultant SEO & GEO, fondateur de MarquePhare
Consultant SEO & GEO. Il accompagne des agences en France, en Espagne et en Andorre sur la visibilité organique, et mesure chaque mois ce que ChatGPT, Claude, Gemini et Perplexity répondent en français — méthodologie publiée, résultats compris quand ils dérangent.
À lire ensuite
Vos clients vous demandent s’ils apparaissent dans ChatGPT. Voici comment transformer la question en prestation : ce qu’elle contient, comment la chiffrer sans promettre l’impossible, les indicateurs à présenter, les objections à anticiper — et les erreurs qui font perdre un client au troisième mois.
SE Ranking propose deux portes d’entrée vers la visibilité IA : un module dans sa suite SEO et un produit séparé, SE Visible, qui couvre la France et le français. Voici ce que contient chacun, ce qu’ils font bien, et les trois questions qui départagent vraiment les outils une fois la langue réglée.